
آنچه در این مقاله میخوانید
مدلهای زبانی بزرگ با وجود توانایی بالا در تولید و تحلیل متن، به دانشی محدود هستند که در زمان آموزش یا در ورودی هر درخواست در اختیارشان قرار گرفته است. RAG برای کاهش این محدودیت، پیش از تولید پاسخ اطلاعات مرتبط را از منابع بیرونی بازیابی و در اختیار مدل قرار میدهد. برای درک دقیق اینکه RAG چیست، باید آن را نه یک مدل مستقل، بلکه معماریای دانست که مدل زبانی را به اسناد، پایگاه دانش و سایر منابع اطلاعاتی متصل میکند. این روش بهویژه برای اطلاعات بهروز، تخصصی یا اختصاصی سازمان کاربرد دارد؛ هرچند پاسخ بدون خطا را تضمین نمیکند و کیفیت منابع و فرایند بازیابی همچنان بر نتیجه اثر میگذارند. در ادامه، نحوه کار RAG، اجزای اصلی، کاربردها، مزایا و محدودیتهای آن را بررسی میکنیم.
RAG چیست؟
RAG مخفف Retrieval-Augmented Generation است که در ترجمه «تولید متن بهبودیافته با بازیابی اطلاعات» معنا میشود. در این معماری، یک سامانه بازیابی اطلاعات در کنار یک مدل مولد قرار میگیرد. وقتی کاربر سؤالی مطرح میکند، ابتدا اطلاعات مرتبط از یک منبع خارجی مانند اسناد، پایگاه دانش، پایگاه داده یا سرویس جستوجو بازیابی میشود؛ سپس این اطلاعات همراه با سؤال در اختیار مدل قرار میگیرد تا پاسخ بر اساس آنها تولید شود. در نتیجه، RAG خودش یک مدل زبانی یا الگوریتم مستقل یادگیری ماشین نیست. معمولاً یک مدل زبانی بزرگ یا LLM بخش تولیدکننده این معماری را تشکیل میدهد. مدل زبانی بزرگ (Large Language Model) مدلی است که بر حجم بزرگی از دادههای زبانی آموزش میبیند و میتواند متن را پردازش و تولید کند.
بدون RAG، مدل برای پاسخگویی عمدتاً به دانش موجود در پارامترهای خود و اطلاعات ورودی متکی است. در این سیستم، اطلاعات مرتبط پیش از تولید پاسخ به مدل اضافه میشوند. این فرایند باعث میشود پاسخ به منبع مشخصی متکی شود. به همین دلیل میتوان اطلاعات بیرونی را بدون آموزش مجدد مدل وارد فرایند پاسخگویی کرد.
RAG چگونه کار میکند؟
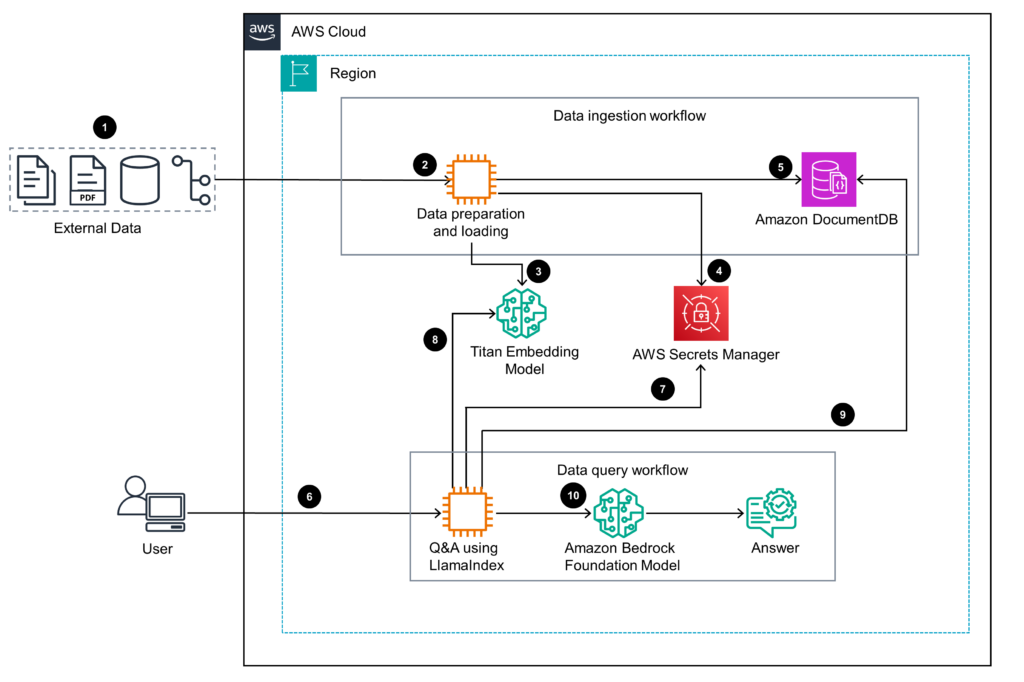
عملکرد RAG را میتوان به دو فرایند اصلی تقسیم کرد؛ نخست، آمادهسازی اطلاعات برای جستوجو و سپس، بازیابی اطلاعات متناسب با پرسش کاربر و ارسال آنها به مدل زبانی. در یک معماری واقعی، جزئیات هر مرحله میتواند متفاوت باشد، اما جریان کلی معمولاً به شکل زیر است:
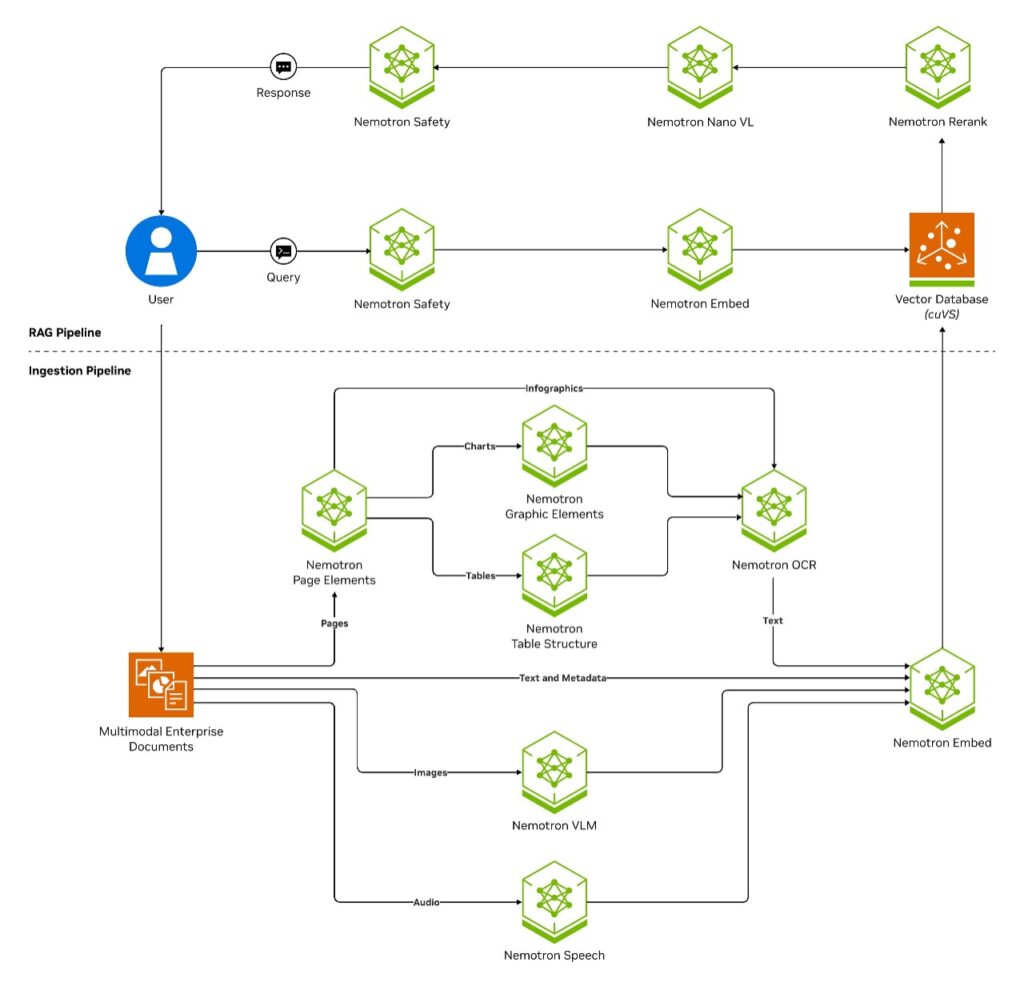
۱. جمعآوری، پاکسازی و دستهبندی دادهها
ابتدا منابع مورد استفاده مدل مشخص میشوند. این منابع میتوانند فایلهای PDF، صفحات وب، آییننامهها، مستندات داخلی، پایگاههای داده یا اطلاعات دریافتی از API باشند. اسناد معمولاً پیش از نمایهسازی پاکسازی و به بخشهای کوچکتری تقسیم میشوند. به این کار تقسیمبندی (Chunking) گفته میشود. هدف این است که هنگام جستوجو، بهجای ارسال یک سند صد صفحهای، بخش محدود و مرتبطی از آن پیدا شود. اندازه Chunk اهمیت زیادی دارد. قطعههای بسیار کوچک ممکن است زمینه لازم برای فهم یک موضوع را از بین ببرند و قطعههای بیش از حد بزرگ نیز میتوانند اطلاعات نامرتبط را وارد مرحله بازیابی کنند.
۲. Embedding و Indexing اطلاعات
در بسیاری از معماریهای RAG، پس از تقسیم متن به بخشهای کوچکتر، نوبت به نمایش برداری (Embedding) و سپس نمایهسازی (Indexing) اطلاعات میرسد. در این مرحله، هر بخش از متن به مجموعهای از اعداد تبدیل میشود که معنای آن را بهصورت عددی نمایش میدهد. به زبان ساده، این کار کمک میکند سیستم متنهای مشابه از نظر مفهوم را تشخیص دهد؛ حتی اگر دقیقاً از کلمات یکسانی استفاده نکرده باشند. مدل نمایش برداری (Embedding Model) برای ایجاد این نمایش عددی از روشهای یادگیری ماشین استفاده میکند. (برای آشنایی بیشتر با این مفهوم میتوانید مقاله یادگیری ماشین چیست را مطالعه کنید.) بردارهای ایجاد شده سپس در یک نمایه جستوجو یا پایگاه داده برداری (Vector Database) ذخیره میشوند تا هنگام دریافت سؤال کاربر، اطلاعات مرتبط سریعتر پیدا شوند.
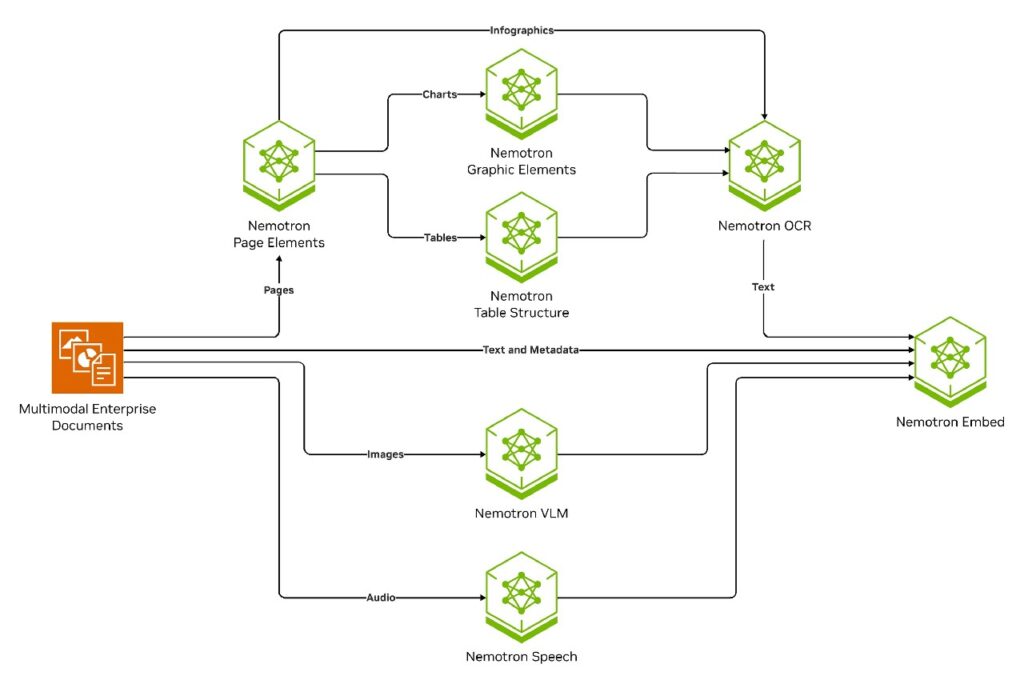
۳. بازیابی اطلاعات مرتبط
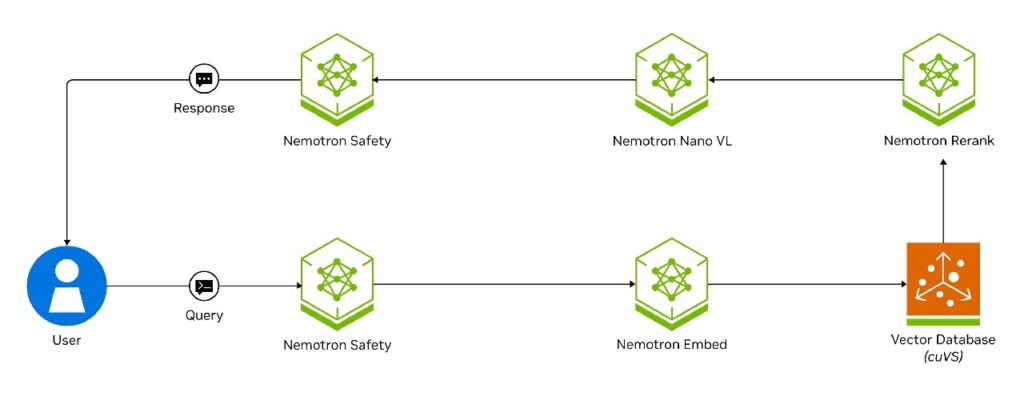
با دریافت سؤال کاربر، لایه جستوجو یا بازیاب (Retriever) باید مناسبترین اطلاعات را پیدا کند. در معماریهای مبتنی بر Embedding، پرسش نیز به بردار تبدیل میشود و سامانه بهدنبال Chunk هایی میگردد که از نظر معنایی به آن نزدیک هستند. بااینحال، بازیابی در RAG الزاماً فقط جستوجوی برداری نیست. جستوجوی کلیدواژهای میتواند برای یافتن اصطلاحات، کدها و نامهای دقیق مفید باشد. بعضی معماریها نیز با Re-ranker نتایج اولیه را دوباره مرتب میکنند تا مرتبطترین موارد در اولویت قرار گیرند.
در مرحله بازیابی، سیستم معمولاً به هر بخش از محتوا یک امتیاز ارتباط با پرسش کاربر اختصاص میدهد. در جستوجوی معنایی، این امتیاز بر اساس میزان نزدیکی نمایش برداری سؤال و محتوا محاسبه میشود؛ برای مثال، معیارهایی مانند Cosine Similarity میتوانند مشخص کنند دو بردار تا چه اندازه به یکدیگر نزدیک هستند. در جستوجوی کلیدواژهای نیز تطابق واژهها و عبارتها مورد توجه قرار میگیرد. بعضی سیستمها این دو روش را در قالب جستوجوی ترکیبی (Hybrid Search) در کنار یکدیگر به کار میگیرند تا هم شباهت معنایی و هم تطابق دقیق عبارتها در نتایج لحاظ شود.
نتایج اولیه در برخی معماریها وارد مرحله بازمرتبسازی (Re-ranking) میشوند. در این مرحله، یک مدل یا الگوریتم رتبهبندی تعداد محدودی از نتایج بازیابیشده را دوباره از نظر ارتباط با سؤال بررسی میکند و مرتبطترین موارد را در رتبههای بالاتر قرار میدهد. روشهای رتبهبندی میتوانند بهصورت Pointwise، یعنی امتیازدهی جداگانه به هر نتیجه، Pairwise یعنی مقایسه دو نتیجه با یکدیگر، یا Listwise یعنی بررسی مجموعهای از نتایج بهعنوان یک فهرست، طراحی شوند. جزئیات این مرحله به معماری و مدل مورد استفاده بستگی دارد.
آیا Vector Database برای RAG الزامی است؟
RAG به یک سازوکار بازیابی نیاز دارد، نه الزاماً یک پایگاه داده برداری. Vector Database (پایگاه دادهای برای ذخیره و جستوجوی بردارهای عددی نشاندهنده معنای محتوا) بهدلیل مناسببودن برای جستوجوی معنایی در بسیاری از پیادهسازیها استفاده میشود؛ اما اطلاعات را میتوان از موتور جستوجو، پایگاه داده، API یا سامانه بازیابی دیگری نیز دریافت کرد. Google Cloud نیز RAG را ترکیبی از LLM با سیستمهای جستوجو و پایگاه داده تعریف میکند و گزینههای متنوعی برای Retrieval در نظر میگیرد.
از نمونههای شناختهشده پایگاههای داده برداری میتوان به Pinecone و Milvus اشاره کرد. Pinecone بیشتر بهصورت یک سرویس مدیریتشده استفاده میشود و بخشی از فرایند راهاندازی، نگهداری و مقیاسپذیری زیرساخت را سادهتر میکند؛ در مقابل، کنترل عملیاتی بیشتری به ارائهدهنده سرویس سپرده میشود. Milvus یک پایگاه داده برداری متنباز است که از اجرای سبک و محلی تا استقرارهای توزیعشده پشتیبانی میکند و انعطاف بیشتری برای مدیریت زیرساخت در اختیار تیم فنی قرار میدهد؛ بااینحال، در حالت Self-hosted، راهاندازی و نگهداری آن میتواند به عملیات فنی بیشتری نیاز داشته باشد. انتخاب میان این گزینهها به عواملی مانند مقیاس پروژه، میزان کنترل مورد نیاز بر زیرساخت، الزامات نگهداری داده و توان عملیاتی تیم بستگی دارد.
۴. تقویت پرامپت با اطلاعات بازیابیشده
پس از اینکه سیستم اطلاعات مرتبط با سؤال کاربر را پیدا کرد، بخشهای بازیابیشده را همراه با خود سؤال در اختیار مدل زبانی قرار میدهد. به این ترتیب، مدل برای تولید پاسخ فقط به دانشی که از قبل آموخته متکی نیست و میتواند از اطلاعاتی استفاده کند که همان لحظه از منابع خارجی دریافت کرده است. برای مثال، اگر کاربر درباره آخرین نسخه یک آییننامه داخلی سؤال کند، سیستم ابتدا بخش مرتبط از نسخه جدید آییننامه را پیدا میکند. سپس سؤال کاربر و همان بخش از سند را با هم برای مدل زبانی میفرستد تا پاسخ بر اساس اطلاعات موجود در سند تولید شود.
۵. تولید پاسخ و ارائه منبع
در مرحله آخر، LLM با استفاده از سؤال و اطلاعات بازیابیشده پاسخ را تولید میکند. اگر سیستم بهگونهای طراحی شده باشد که منبع پاسخ را هم نشان دهد، کاربر میتواند ببیند پاسخ از کدام سند یا کدام بخش از اطلاعات استخراج شده است. این موضوع کمک میکند پاسخ فقط بهصورت یک نتیجه نهایی دیده نشود و کاربر بتواند منبع آن را نیز بررسی و صحت اطلاعات را ارزیابی کند.
اجزای اصلی معماری RAG در یک نگاه
اجزای متداول معماری RAG را میتوان بهصورت زیر خلاصه کرد:
| مولفه | کارکرد در معماری RAG |
| منبع داده و پایگاه دانش | تأمین اسناد و اطلاعات لازم به عنوان منبع دانش سیستم |
| پردازش و قطعهبندی محتوا (Chunking) | آمادهسازی اسناد و تقسیم آنها به بخشهای کوچکتر و قابل جستوجو |
| مدل نمایش برداری (Embedding Model) | تبدیل متن به نمایش عددی برای مقایسه معنایی محتوا |
| لایه جستوجو و بازیابی (Search / Retrieval) | پیدا کردن اطلاعات مرتبط با پرسش کاربر |
| پایگاه داده برداری یا نمایه جستوجو | ذخیره و سازماندهی اطلاعات برای بازیابی سریعتر |
| بازمرتبساز (Re-ranker)، در صورت استفاده | بررسی دوباره نتایج و قرار دادن مرتبطترین موارد در اولویت |
| مدل زبانی بزرگ (LLM) | تولید پاسخ با استفاده از سؤال و اطلاعات بازیابیشده |
| لایه هماهنگکننده (Orchestration) | مدیریت جریان اطلاعات و ارتباط میان بخشهای مختلف سیستم |
چرا از RAG استفاده میشود و چه مزایایی دارد؟
یکی از محدودیتهای مدلهای زبانی این است که دانش آموختهشده آنها به دادههای آموزشی وابسته است. در نتیجه، ممکن است مدل درباره اطلاعات جدید، سیاستهای داخلی یک شرکت یا اسنادی که هرگز در دوره آموزش ندیده است، دانش کافی نداشته باشد. RAG بهجای آموزش دوباره مدل، اطلاعات مورد نیاز را در زمان پاسخگویی از منابع مرتبط بازیابی و در اختیار مدل قرار میدهد.
این معماری چند مزیت مهم دارد؛ امکان استفاده از اطلاعات بهروز و اختصاصی، بهروزرسانی پایگاه دانش بدون آموزش مجدد مدل، کنترل بیشتر بر منابع پاسخ و امکان نمایش منبع مرجع. برای نمونه، اگر آییننامه سازمان تغییر کند، میتوان نسخه جدید را وارد پایگاه دانش کرد؛ بدون آنکه برای هر تغییر، LLM دوباره آموزش ببیند.
RAG همچنین میتواند احتمال توهم هوش مصنوعی (Hallucination) را کاهش دهد، زیرا مدل برای پاسخ به اطلاعات مرتبط و انتخابشده دسترسی پیدا میکند. بااینحال، این مزیت نباید بهصورت تضمین «حذف توهم» بیان شود. اگر اطلاعات نادرست بازیابی شوند یا مدل از اطلاعات بازیابیشده (Context) بهدرستی استفاده نکند، پاسخ همچنان ممکن است اشتباه باشد.
کاربردهای RAG چیست؟
RAG زمانی کاربرد بیشتری دارد که پاسخ باید بر اطلاعات مشخص و قابل اعتماد تکیه کند؛ اطلاعاتی که ممکن است در دادههای آموزشی مدل وجود نداشته باشند یا مرتب بهروزرسانی شوند. به همین دلیل، این معماری در بسیاری از کاربردهای سازمانی و مبتنی بر دانش مورد استفاده قرار میگیرد. در ادامه به برخی از کاربردهای RAG اشاره میکنیم.
چتبات و دستیار هوشمند سازمانی
سازمانها میتوانند دستیار هوشمندی ایجاد کنند که به راهنماها، دستورالعملها و اسناد داخلی متصل باشد. برای مثال، یک کاربر میتواند درباره فرایند ثبت درخواست خرید سؤال کند و مدل بهجای جستوجو در چند سامانه یا سند مختلف، پاسخ را بر اساس آییننامه مرتبط دریافت کند.
جستوجو و پرسشوپاسخ در اسناد
RAG میتواند جستوجو در مجموعه بزرگی از اسناد را از «پیدا کردن فایل» به «دریافت پاسخ» نزدیک کند. برای مثال، کاربر درباره بند مشخصی از چند سند فنی سؤال میکند و سیستم بخشهای مرتبط را پیدا و خلاصه میکند.
پشتیبانی مشتری بر اساس مستندات
تیمهای پشتیبانی میتوانند از RAG برای تهیه پاسخ بر اساس مستندات محصول، راهنماهای استفاده و پرسشهای متداول تایید شده استفاده کنند. با بهروزرسانی این منابع، پاسخهای سیستم نیز میتوانند بدون نیاز به آموزش دوباره مدل بر اساس اطلاعات جدید تولید شوند.
تحلیل قراردادها، آییننامهها و گزارشها
در یک سناریوی فرضی، مدیر میتواند از میان مجموعهای از قراردادها درباره شرایط فسخ یا تعهدات مشخص پرسوجو کند. البته پاسخ سیستم باید همراه منبع بررسی شود و در موضوعات حساس جایگزین ارزیابی متخصص انسانی نیست.
دستیار مدیریت دانش و آموزش
RAG در سامانههای مدیریت دانش و آموزش نیز کاربرد دارد. یک دستیار میتواند به پایگاه دانش داخلی، محتوای آموزشی و مستندات فنی متصل شود و پاسخ کاربران را بر اساس همین منابع ارائه دهد. به این ترتیب، دسترسی به دانش سازمانی سادهتر و سریعتر میشود.
محدودیتها و چالشهای RAG چیست؟
کیفیت یک سیستم RAG فقط به توانایی مدل زبانی بستگی ندارد و تمام مراحل آمادهسازی، بازیابی و استفاده از اطلاعات بر نتیجه نهایی اثر میگذارند. اگر منبع مناسب در پایگاه دانش وجود نداشته باشد، اسناد بهدرستی قطعهبندی نشده باشند یا سامانه بازیابی بخش نامرتبطی را انتخاب کند، مدل زبانی نیز اطلاعات مناسبی برای تولید پاسخ در اختیار نخواهد داشت. Google Cloud نیز کیفیت بازیابی اطلاعات را یکی از عوامل مهم در کیفیت پاسخ سیستمهای RAG معرفی میکند.
از مهمترین چالشهای RAG میتوان به کیفیت و بهروز بودن منابع، بازیابی اطلاعات نامرتبط، انتخاب نامناسب اندازه قطعههای متن، افزایش زمان پاسخ، هزینه پردازش و ذخیرهسازی، نگهداری و بهروزرسانی پایگاه دانش و پیچیدگی بیشتر در پایش عملکرد سیستم اشاره کرد. در کاربردهای سازمانی، کنترل دسترسی نیز اهمیت زیادی دارد. اگر کاربری اجازه مشاهده یک سند را نداشته باشد، سامانه بازیابی نیز نباید اطلاعات آن سند را در اختیار مدل قرار دهد. به این ترتیب، محدودیتهای دسترسی باید از همان مرحله بازیابی اطلاعات اعمال شوند.
کیفیت RAG را چگونه ارزیابی میکنند؟
ارزیابی RAG معمولاً در دو بخش انجام شود؛ کیفیت بازیابی اطلاعات و کیفیت پاسخ تولیدشده. ابتدا باید بررسی شود که آیا سامانه بازیابی، سند یا بخش مناسبی از متن را پیدا کرده است یا نه. سپس باید دید پاسخ مدل واقعاً بر همان اطلاعات تکیه دارد و با آنها سازگار است یا خیر.
این تفکیک برای پیدا کردن علت خطا اهمیت زیادی دارد. ممکن است مدل زبانی عملکرد خوبی داشته باشد، اما اطلاعات نامرتبطی در اختیار آن قرار گرفته باشد. در حالت برعکس نیز ممکن است سند درست بازیابی شود، اما مدل آن را نادرست تفسیر کند. بنابراین، بررسی میزان مرتبطبودن اطلاعات بازیابیشده و میزان انطباق پاسخ با همان اطلاعات، به شناسایی دقیقتر منشأ خطا کمک میکند.
تفاوت RAG و Agentic RAG چیست؟
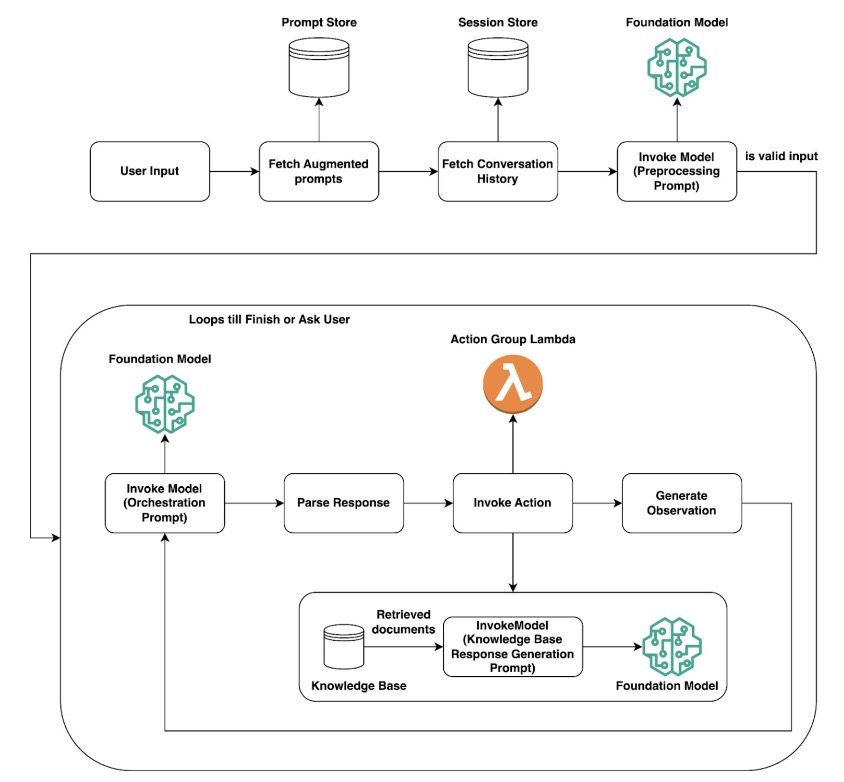
در RAG معمولی، مسیر پاسخگویی تا حد زیادی از قبل مشخص است؛ سؤال کاربر دریافت میشود، اطلاعات مرتبط بازیابی میشوند، این اطلاعات در اختیار مدل قرار میگیرند و در نهایت پاسخ تولید میشود. RAG عاملی (Agentic RAG) این فرایند را انعطافپذیرتر و تصمیممحورتر میکند.
در RAG عاملی، سیستم میتواند بر اساس نوع سؤال تصمیم بگیرد چه زمانی جستوجو کند، از کدام منبع یا ابزار استفاده کند یا اینکه برای رسیدن به پاسخ به چند مرحله جستوجو نیاز دارد یا نه. برای مثال، ممکن است یک سؤال پیچیده را به چند بخش تقسیم کند، اطلاعات را از منابع مختلف بررسی کند و در صورت کافینبودن نتایج، دوباره جستوجو انجام دهد. به همین دلیل، RAG عاملی برای وظایف پیچیده و چندمرحلهای مناسبتر است؛ هرچند میتواند زمان پردازش و پیچیدگی سیستم را نیز افزایش دهد.
این رویکرد با مفاهیم هوش مصنوعی عاملی ارتباط نزدیکی دارد؛ زیرا عامل هوشمند بخشی از تصمیمگیری درباره مسیر بازیابی را بر عهده میگیرد.
چه زمانی استفاده از RAG مناسب است؟
برای تصمیمگیری درباره استفاده از RAG، باید ابتدا مشخص شود که پاسخ سیستم تا چه اندازه به اطلاعات خارج از دانش مدل وابسته است. RAG معمولاً زمانی ارزش بیشتری ایجاد میکند که اطلاعات مرتب تغییر کنند، دادههای اختصاصی سازمان در پاسخ نقش داشته باشند، پاسخ باید به منابع مشخص و قابل بررسی متکی باشد یا حجم اطلاعات آنقدر زیاد باشد که قرار دادن همه آنها در ورودی مدل منطقی نباشد.
برای مثال، در یک پایگاه دانش سازمانی شامل هزاران سند، دستورالعمل و مستند محصول، ارسال همه اطلاعات برای هر سؤال امکانپذیر یا بهینه نیست. RAG میتواند ابتدا بخشهای مرتبط را پیدا کند و فقط همان اطلاعات را برای تولید پاسخ در اختیار مدل قرار دهد.
چه زمانی RAG لازم نیست؟
اگر مجموعه اطلاعات کوچک و ثابت است، میتوان در برخی موارد اطلاعات لازم را مستقیماً همراه پرامپت به مدل ارائه کرد. همچنین برای وظایفی مانند بازنویسی، ایدهپردازی یا تولید متن بر اساس دستور کاربر که نیازی به جستوجوی دانش خارجی ندارند، بازیابی دادهها لزوماً ضروری نیست. در واقع میتوان گفت اگر بازیابی اطلاعات خارجی کیفیت یا قابلیت کنترل پاسخ را بهبود نمیدهد، وجود RAG بهخودیخود یک مزیت نیست. بنابراین، پیش از پیادهسازی باید مشخص شود که دسترسی به اطلاعات خارجی واقعاً چه ارزشی برای پاسخهای سیستم ایجاد میکند.
برای پیادهسازی RAG به چه زیرساختی نیاز داریم؟
زیرساخت RAG بسته به اندازه پروژه و حساسیت دادهها متفاوت است، اما معمولاً شامل مدل زبانی بزرگ، فضای ذخیرهسازی اسناد، سامانه پردازش و نمایهسازی، لایه جستوجو و بازیابی و منابع پردازشی است. در معماریهای مبتنی بر جستوجوی معنایی، مدل نمایش برداری (Embedding Model) و جستوجوی برداری نیز استفاده میشوند. در پروژههای سازمانی، پایش کیفیت، کنترل دسترسی و حفاظت از دادهها نیز باید از ابتدا در طراحی در نظر گرفته شوند.
اگر در حال بررسی راهاندازی یک دستیار هوشمند، سامانه RAG یا سایر راهکارهای مبتنی بر مدلهای زبانی هستید، انتخاب زیرساخت مناسب یکی از تصمیمهای مهم پروژه است. برای آشنایی با مدلهای زبانی، منابع GPU و زیرساختهای قابل استفاده در این مسیر، میتوانید سرویسهای هوش مصنوعی ابرآمد را بررسی کنید و گزینههای متناسب با نیاز پروژه خود را بشناسید.
سؤالات متداول درباره RAG
RAG مخفف چیست؟
RAG مخفف Retrieval-Augmented Generation و به معنای «تولید متن بهبودیافته با بازیابی اطلاعات» است.
آیا RAG یک مدل هوش مصنوعی است؟
خیر؛ RAG یک معماری یا الگوی نرمافزاری است که معمولاً یک مدل زبانی بزرگ را با سامانه بازیابی اطلاعات و منابع دانش خارجی ترکیب میکند.
آیا RAG توهم (گیج شدن) هوش مصنوعی را کاملاً از بین میبرد؟
خیر؛ دسترسی مدل به منابع معتبر و مرتبط میتواند احتمال تولید اطلاعات نادرست را کاهش دهد، اما خطای Retrieval، ضعف منابع یا تفسیر اشتباه مدل همچنان میتواند به پاسخ نادرست منجر شود.
تفاوت RAG با Fine-tuning چیست؟
RAG هنگام پاسخگویی دانش خارجی را در اختیار مدل قرار میدهد؛ Fine-tuning با آموزش تکمیلی، پارامترها و رفتار مدل را تغییر میدهد
آیا RAG حتماً به پایگاه داده برداری نیاز دارد؟
خیر؛ پایگاه داده برداری یکی از روشهای رایج برای جستوجوی معنایی است، اما تنها گزینه موجود نیست. RAG میتواند برای پیدا کردن اطلاعات مرتبط از موتور جستوجو، پایگاه داده، جستوجوی کلیدواژهای، جستوجوی ترکیبی یا سایر سامانههای بازیابی اطلاعات استفاده کند.
آیا میتوان از RAG برای اطلاعات محرمانه سازمان استفاده کرد؟
بله، اما معماری سیستم باید متناسب با حساسیت دادهها طراحی شود. احراز هویت، کنترل دسترسی، رمزگذاری، مدیریت مجوزها و نحوه نگهداری اطلاعات باید از ابتدا مشخص باشند. برای مثال، اگر کاربری اجازه مشاهده یک سند را ندارد، سامانه بازیابی نیز نباید اطلاعات آن سند را در اختیار مدل قرار دهد یا از آن برای تولید پاسخ به همان کاربر استفاده کند.
RAG در هوش مصنوعی چیست؟
RAG در هوش مصنوعی معماریای است که مدل زبانی را به منابع اطلاعاتی بیرونی متصل میکند تا پیش از تولید پاسخ، اطلاعات مرتبط را بازیابی و بر اساس آنها پاسخ دقیقتری ارائه کند.
این مقاله را به اشتراک بگذارید
به این مطلب امتیاز دهید
مطالب مرتبط:
